Apache Spark 설정
2026. 1. 7. 17:02ㆍ카테고리 없음
services:
  zookeeper:
    image: wurstmeister/zookeeper
    container_name: zookeeper
    ports:
      - "2181:2181"

  kafka:
    image: wurstmeister/kafka
    container_name: kafka
    ports:
      - "9092:9092"
    environment:
      KAFKA_ADVERTISED_HOST_NAME: localhost
      KAFKA_ZOOKEEPER_CONNECT: zookeeper:2181
    volumes:
      - /var/run/docker.sock:/var/run/docker.sock
    depends_on:
      - zookeeper

  spark-master:
    image: apache/spark:3.5.0-python3
    container_name: spark-master
    ports:
    - "8080:8080"
    - "7077:7077"
    command: /opt/spark/bin/spark-class org.apache.spark.deploy.master.Master

  spark-worker:
    image: apache/spark:3.5.0-python3
    container_name: spark-worker
    depends_on:
      - spark-master
    environment:
      - SPARK_WORKER_CORES=1
      - SPARK_WORKER_MEMORY=1g
    command: /opt/spark/bin/spark-class org.apache.spark.deploy.worker.Worker spark://spark-master:7077
https://hub.docker.com/r/bitnamicharts/spark/tags
1. 서비스 구조: Master와 Worker
Spark는 혼자 일하지 않고 역할을 나누어 일을 처리합니다.
- spark-master (대장):
- 전체적인 스케줄링을 담당합니다.
- 어떤 일꾼(Worker)에게 어떤 작업을 시킬지 결정하고 관리합니다.
- spark-worker (일꾼):
- 대장에게 받은 실제 데이터를 연산하고 처리하는 역할을 합니다.
- 데이터가 많아지면 이 Worker 컨테이너 개수를 늘려서 처리 속도를 높일 수 있습니다.
2. 주요 설정 항목 분석
🔹 Spark Master 설정
- image: apache/spark:3.5.0-python3: apache spark 3.5 버전
- ports:
- 8080:8080: Web UI 포트입니다. 브라우저에서 localhost:8080에 접속하면 현재 내 Spark가 잘 돌아가는지, 일꾼들이 몇 명인지 시각적으로 확인할 수 있습니다.
- 7077:7077: 내부 통신 포트입니다. 일꾼(Worker)들이 대장에게 "저 출근했습니다!"라고 보고할 때 사용하는 통로입니다.
- command: /opt/spark/bin/spark-class org.apache.spark.deploy.master.Master
- /opt/spark/bin/spark-class: 스파크 내부의 자바(Java) 클래스를 실행하기 위한 범용 실행 도구입니다. 스파크의 모든 핵심 기능은 이 도구를 거쳐서 실행됩니다.
- org.apache.spark.deploy.master.Master: 실제 실행할 **자바 클래스의 전체 이름(Full Name)**입니다. 이 클래스가 실행되면 스파크 클러스터의 "대장(Master)" 프로세스가 시작됩니다.
- 이 프로세스는 워커들의 상태를 관리하고, 우리가 제출할 분석 작업(Job)을 누구에게 시킬지 결정하는 역할을 합니다.
🔹 Spark Worker 설정
- depends_on: - spark-master: 대장이 먼저 출근해야 일꾼이 일을 시작할 수 있으므로 실행 순서를 보장합니다.
SPARK_WORKER_CORES: 1
SPARK_WORKER_MEMORY: 1G- 의미: 워커 컨테이너가 사용할 자원의 한도를 정해주는 것입니다.
- 공식 이미지에서 이 변수들을 설정해두면, 아래 command가 실행될 때 내부적으로 이 값을 읽어서 "나는 CPU 1개랑 메모리 1GB만 쓰는 일꾼이다"라고 마스터에게 보고하게 됩니다.
- command: /opt/spark/bin/spark-class org.apache.spark.deploy.worker.Worker spark://spark-master:7077
- org.apache.spark.deploy.worker.Worker: "일꾼(Worker)" 프로세스를 시작하는 클래스입니다.
- spark://spark-master:7077: 가장 중요한 부분입니다. 워커가 누구에게 보고해야 할지 알려주는 마스터의 주소입니다.
- spark-master: Docker Compose 서비스 이름 (도커 내부 DNS가 이 이름을 IP로 바꿔줍니다).
- 7077: 스파크 마스터와 워커가 통신할 때 사용하는 기본 포트입니다. (8080은 관리자용 웹 화면 포트고, 7077은 실제 데이터/명령용 포트입니다.)
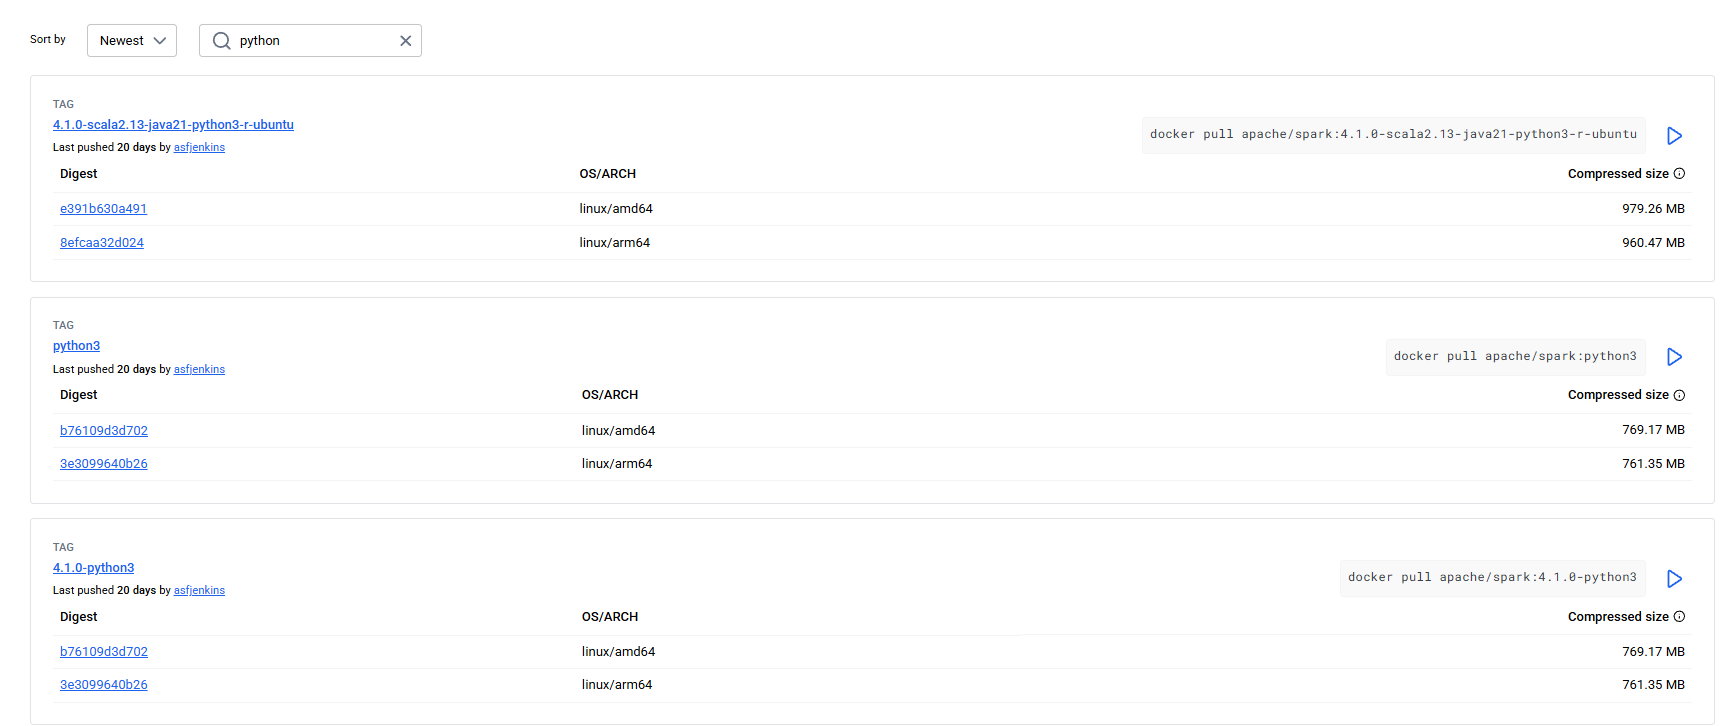
태그 읽는 법
- 4.1.0: Spark 엔진 버전
- scala2.13: 내부적으로 사용하는 스칼라 언어 버전 (우리는 무시해도 됨)
- java21: 실행 기반이 되는 자바 버전
- python3: 우리가 꼭 필요한 파이썬 환경
- ubuntu: 컨테이너의 기본 운영체제
반응형